robots.txtの効き方を確かめる手順|決め手の行まで見る
robots.txt を貼り付けて、URL ごとにクロールしてよいかを確かめる手順です。決め手になった行の番号、名前ごとに使われる組、読まれていない行の見つけ方まで、画面を追って説明します。
公開読了目安 約5分
この記事の要点
- 貼り付けた robots.txt で URL ごとの可否が出る
- 決め手になった行の番号がそのまま分かる
- 名前の組があると、共通の規則は使われない
- 全角のコロンなど、読まれない行を名指しする
- サイトへは取りに行かず、貼った文字だけで判定する
目次
robots.txt に書いた行が、本当に狙った URL を止めているか。 robots.txtテスターは、それを 1 件ずつ表で確かめるツールです。
貼り付けた中身と URL を入れると、止まるかどうかと、その決め手の行が並びます。 書いたつもりで効いていない行も、行番号つきで知らせます。
「止めたはずなのに」あるある 3 つ
ブログやサイトを運営していると、robots.txt で次のような食い違いが起きます。
- 管理画面を止めたつもりが、検索用のクローラーには効いていなかった
- 行の見た目は正しいのに、なぜか何も止まっていなかった
- 開けたいページまで一緒に止めてしまっていた
どれも、書いた本人が読み返しても気づきにくい形です。 行の並びや 1 文字の違いで、読まれ方が変わるためです。
なぜ見た目どおりに効かないのか
robots.txt は、クローラーの名前ごとに「組」を作って読みます。
ある名前の組があると、その名前には共通の組(*)の行が使われません。
止めるか開けるかは、書いた順番ではなく行の長さで決まります。 短い「止める」行より、長い「開ける」行が勝ちます。
さらに、区切りの「:」が全角だと、その行は丸ごと読まれません。 見た目では、半角と全角の違いがほとんど分からないのが厄介なところです。
robots.txtテスターの使い方
1. 中身と名前と URL を入れる
ブラウザでサイトの /robots.txt を開き、表示された中身を上の欄に貼ります。
名前の欄には、調べたいクローラーの名前を入れます。
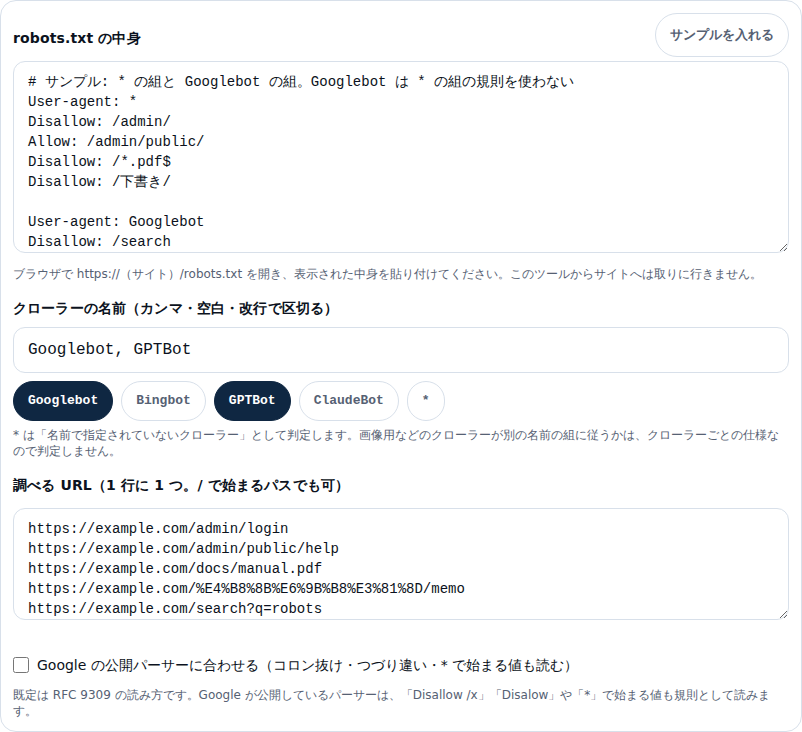
候補のボタンを押すと、名前を足したり外したりできます。
URL は 1 行に 1 つずつ、/ で始まる形でもかまいません。
2. 判定と決め手の行を読む
名前ごとにカードが出て、URL ごとに「クロール可」か「ブロック」が並びます。 その下の「決め手」が、判定を決めた行の番号と中身です。
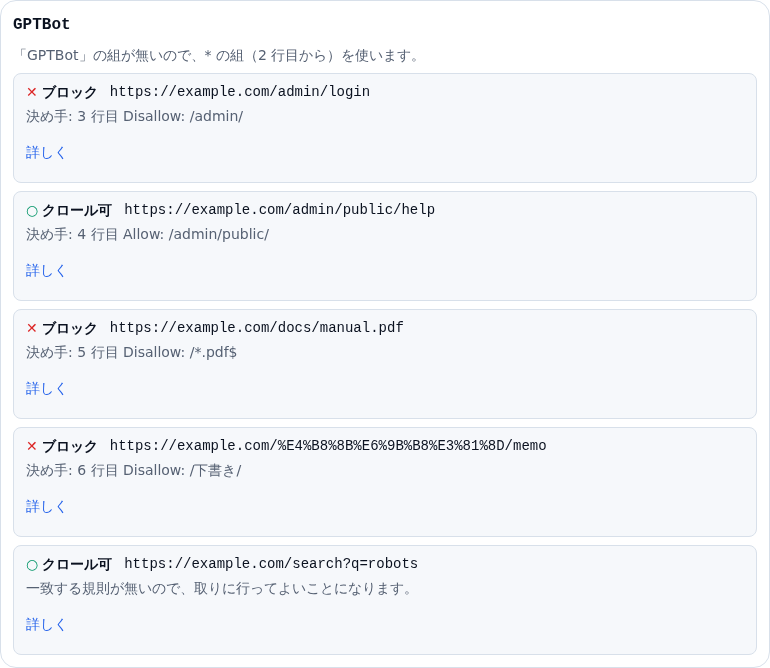
GPTBot は名前の組が無いので、共通の組の行が使われています。
/admin/public/help だけは 4 行目の「開ける」行が決め手で、クロール可です。
3. 名前の組があるときの違いを見る
同じ中身でも、Googlebot のカードは結果が変わります。 Googlebot には専用の組があるので、共通の組の行は使われません。
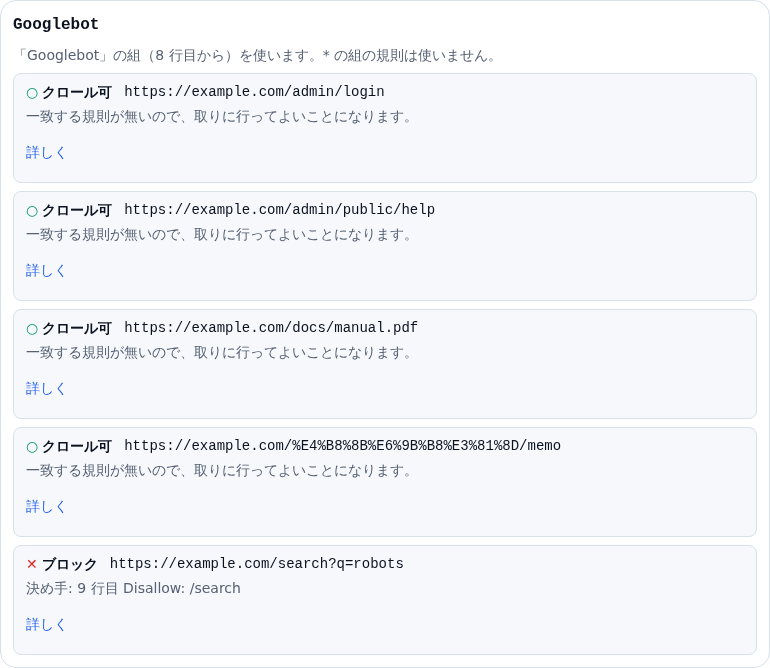
管理画面を止める行は共通の組にしか無いので、Googlebot には効いていません。 カードの上の説明文で、どの組を使ったかを必ず確かめてください。
4. 「詳しく」で一致した行をすべて見る
「詳しく」を開くと、その URL に当てはまった行が長い順に並びます。 長さの数字が大きい行ほど強い、という読み方です。
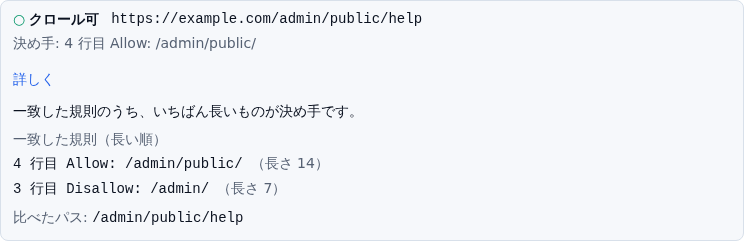
止める行(長さ 7)と開ける行(長さ 14)の両方が当てはまり、長いほうが勝っています。 同じ長さで並んだときは、開けるほうが勝ちます。
5. 行の指摘で読まれていない行を探す
結果の下には「行の指摘」が並びます。 読まれない行と、どの URL にも当たらない行に印が付きます。
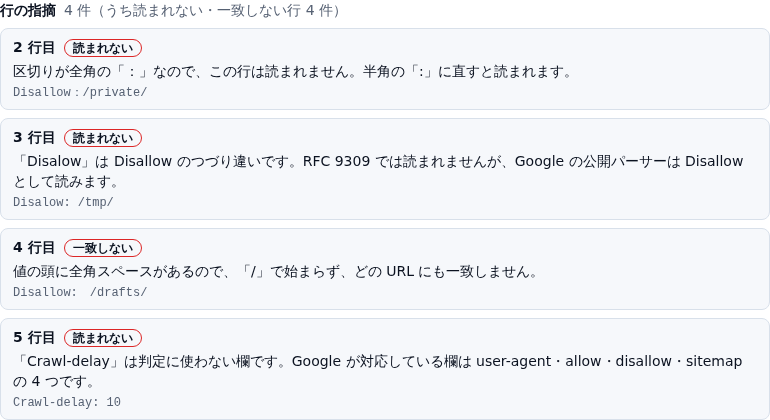
全角のコロンや全角スペースは、日本語の入力のまま書くと混ざりやすい文字です。 指摘の行番号を見て、半角に直してから貼り直してください。
こんな場面で使える
- ブログのテーマを変える前に、今の robots.txt が何を止めているかを控える
- AI 用のクローラーだけを止める行を足したとき、検索用の名前と並べて比べる
- 日本語のカテゴリ名を含むフォルダを止める行が、実際の URL に当たるかを試す
- 引き継いだサイトの長い robots.txt から、効いていない行を洗い出す
使用例
たとえば、ブログの下書きフォルダを止めたい運営者が、次の 2 行を足したとします。
Disallow: /下書き/ と書き、ブラウザのアドレス欄から URL をコピーして入れます。
アドレス欄からコピーした URL は %E4%B8%8B… のような形になりますが、判定はブロックと出ます。
日本語の行と、記号に置き換わった URL をそろえてから比べているためです。 書き方を変えずにそのまま置いてよいことが、公開前に分かります。
安心して使えるポイント
robots.txt を取りに行く機能はありません。 入力した robots.txt と URL は外部に送らず、ブラウザの中だけで判定します。
公開前の下書きや、社内だけのサイトの設定でも同じように試せます。
関連ツール
- URLエンコード・デコード:日本語の URL と
%E4…の形を行き来する - 正規表現テスター:
*のような記号で文字列を探す考え方を試す - OGPプレビュー:公開前に SNS での見え方を確かめる
- .gitignoreテスター:Git で外すファイルを、同じように決め手の行つきで確かめる
まとめ
robots.txt の効き方は、名前の組・行の長さ・1 文字の全角で変わります。 見た目で読むより、URL を並べて決め手の行を見るほうが確実です。
止めたことと検索結果から消えることは別の話です。 その違いは「robots.txt でブロックしたのに検索結果に出る理由」で説明しています。
補足: 開発者の方へ
判定は RFC 9309 の手順どおりです。 クローラー名は大文字小文字を区別せずに組と照合し、同じ名前の組が複数あれば規則をまとめます。
一致した規則のうち、パーセントエンコードをそろえた後のオクテット数が最大のものを採ります。 同じ長さの Allow と Disallow は Allow です。
比べる前に、ASCII 外の文字は UTF-8 の %XX に、非予約文字の %XX は元の文字に戻します。
URL 側の * と $ は %2A と %24 として扱い、ワイルドカードとして読みません。
「Google の公開パーサーに合わせる」を入れると、読み方が google/robotstxt と同じになります。
コロン抜け・Disallow のつづり違い・* で始まる値も規則として読みます。
あわせて読みたい
同じテーマ・関連ツールの記事です。